
Aller au contenu principal

Renommeur intelligent de bibliothèque DJ.

Renommage par lots déterministe basé sur les métadonnées et l'analyse acoustique.

Load audio files, folders or playlists

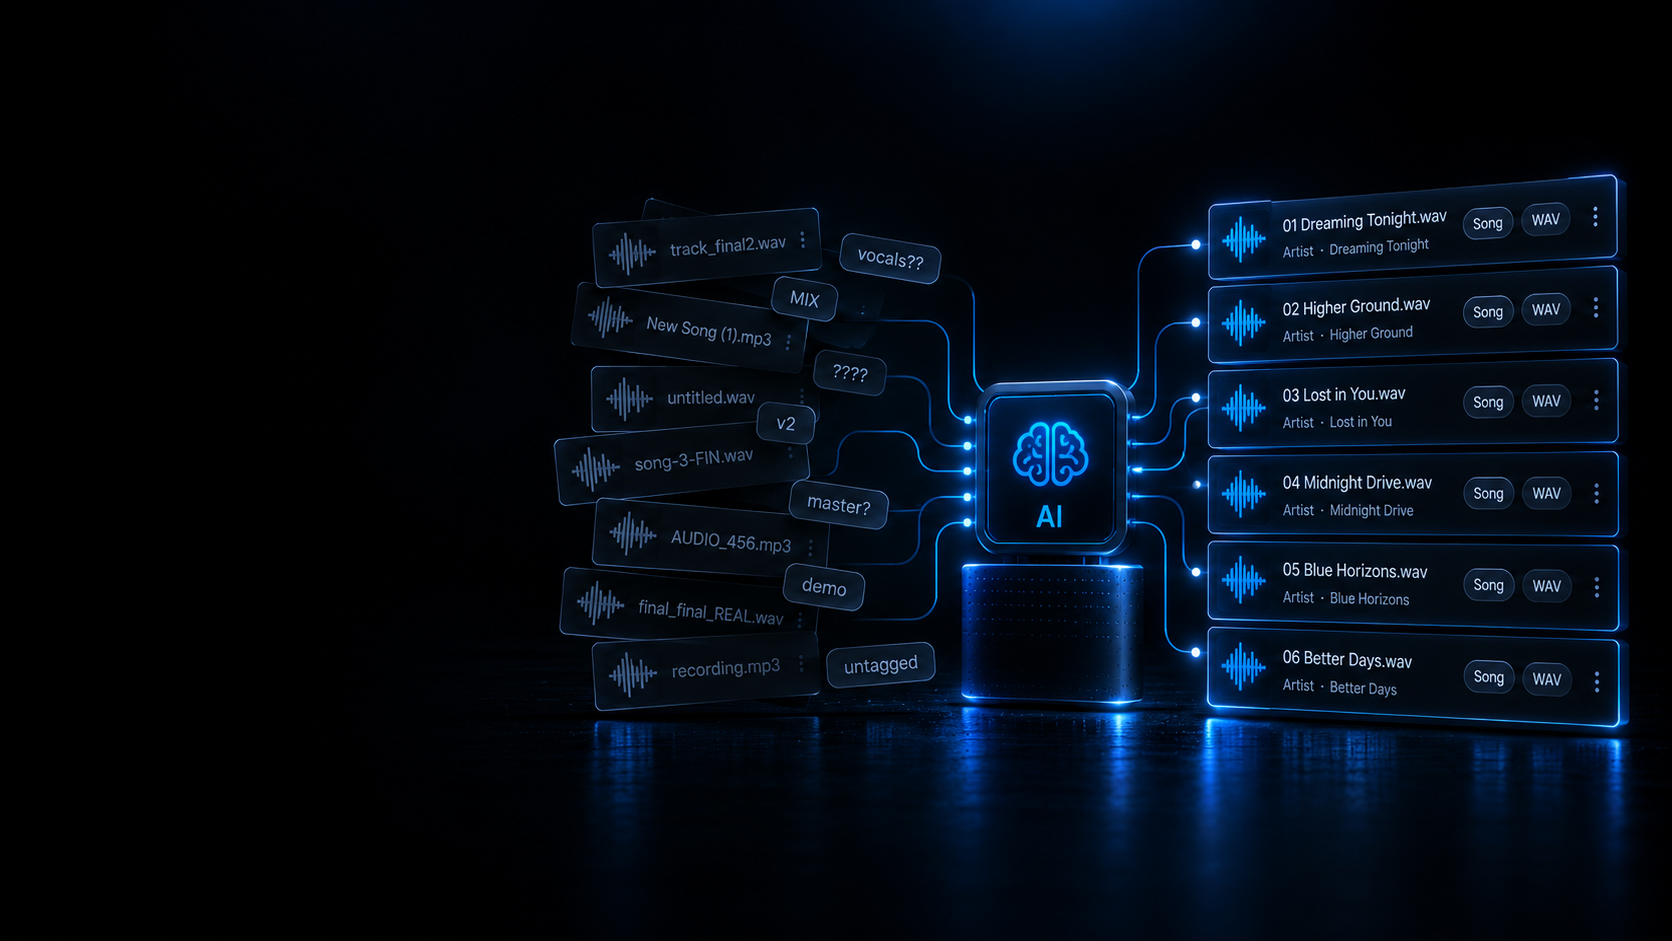
Inspect metadata tags, detect messy names, and batch rename automatically or with manual inline edits.

Glissez vos morceaux audio ici ou cliquez pour parcourir

Lossless (WAV, FLAC, AIFF) et Lossy (MP3, AAC, M4A) · Traitement strictement local

Renommage par lots dans ton navigateur

Renommage de fichiers audio par lots : renommer les MP3 depuis les tags ID3

Charge un dossier ou quelques fichiers, l’analyse lit les tags de chaque piste, le tableau affiche le nom actuel à côté d’une proposition que tu peux éditer à la main, et tu télécharges un paquet de scripts à exécuter sur ta machine. Tout est calculé dans ton navigateur : l’audio n’est jamais envoyé, aucun tag n’est écrit et aucun fichier ne bouge tant que tu n’as pas lancé le script.

Comment le nom est construit : Toujours "Artiste - Titre" Extension conservée octet pour octet Budget de 255 octets UTF-8 Collisions numérotées (2), (3)…
Formats que tu peux charger : MP3 WAV FLAC AIFF / AIF OGG M4A AAC

Ce que cet outil fait vraiment

Quatre capacités que tu peux vérifier dans le code, pas dans un argumentaire commercial.

Des noms construits à partir des tags du fichier

Le moteur prend l’artiste et le titre lus dans les tags ID3, Vorbis ou MP4 et propose "Artiste - Titre.ext". Si un seul des deux champs existe, la ligne reste en confiance basse avec une note explicite, et si aucun ne propose une valeur utilisable, la piste part dans le bac "non résoluble" au lieu de recevoir un nom inventé.

  • L’artiste et le titre viennent d’une lecture locale des tags, jamais d’une requête en ligne.
  • Les valeurs parasites comme "Untitled", "www.…" ou "320 kbps" sont refusées au lieu de devenir un nom.

Un assainisseur pour Windows, macOS et Linux à la fois

Les caractères interdits deviennent un espace ("AC/DC" devient "AC DC"), les séries d’espaces se replient, les points et espaces finaux sont retirés, les noms de périphériques Windows comme CON reçoivent un tiret bas devant et le résultat est coupé à 255 octets UTF-8 sur des limites de points de code — le plus strict des budgets NTFS, ext4 et APFS.

  • L’extension est préservée octet pour octet, casse comprise.
  • Un nom qui resterait vide retombe sur "track", et un nom interdit est corrigé en confiance haute.

Les collisions sont signalées et numérotées

Deux pistes qui résolvent vers la même cible apparaissent toutes deux comme conflit avec un suffixe déterministe " (2)", " (3)"… vérifié contre tous les autres noms que le plan laisse sur le disque, donc aucun script ne peut écraser un fichier. La comparaison ne regarde que les noms, deux fichiers homonymes dans des dossiers différents sont donc aussi signalés.

  • Aucune proposition n’atterrit jamais sur un nom qu’un autre fichier conserve.
  • Les conflits sont affichés pour révision, jamais résolus en silence.

Propositions éditables et paquet téléchargeable

Chaque nom proposé est un champ texte que tu réécris directement dans le tableau, avec un bouton de réinitialisation vers la suggestion, et le plan se régénère avec tes modifications. Un clic télécharge rename-files.ps1 pour Windows, rename-files.sh pour macOS et Linux, rename-map.csv pour relecture et README-undo.txt avec les étapes de restauration.

  • Le script crée rename-undo.csv avant de renommer quoi que ce soit et refuse de tourner s’il ne peut pas l’écrire.
  • Un nom contenant un saut de ligne ou un NUL reste hors du paquet et est listé dans le README.

Cas d’usage réels

Ce que cette vue résout avant que tu charges la clé USB.

Cas 1 · Téléchargements aux noms sales

Tirets bas, "(1)" et suffixes de copie

Les téléchargements arrivent en Track_01_(1).mp3 ou "titre copy 2.flac" : le plan reconnaît les tirets bas utilisés à la place des espaces, les suffixes de doublon et les étiquettes de débit dans le nom, et propose le nom propre construit depuis les tags.

Cas 2 · Noms que Windows refuse

Caractères interdits et noms réservés

Un fichier avec ?, | ou : dans son nom ne s’ouvre pas sous Windows, et une racine comme CON ou AUX est un nom de périphérique réservé : l’assainisseur corrige les deux en confiance haute et la colonne de raison nomme exactement le caractère qui pose problème.

Cas 3 · Avant le direct

Une seule convention pour tout le dossier

Avec une bibliothèque mêlée de plusieurs pools, le tableau montre une convention de noms unique sur tout le dossier et te laisse filtrer par "à renommer", "conflits" ou "déjà propre" avant de télécharger le moindre script.

Cas 4 · Deux fichiers, un nom

Le même titre dans deux dossiers

Quand deux pistes résolvent vers le même "Artiste - Titre.mp3", les deux apparaissent comme conflit avec un suffixe numéroté, pour que tu vérifies s’il s’agit de doublons avant que le script ne touche le moindre fichier.

Ce que ça produit et ce que ça ne produit pas

Mieux vaut le dire ici que de le découvrir au milieu d’un grand ménage.

L’outil travaille sur des analyses déjà calculées dans ton navigateur : il lit les tags — le nom n’utilise que l’artiste et le titre, même si l’analyse partagée collecte aussi l’album, l’année, le genre, la plage, l’ISRC, le commentaire, l’artiste de l’album et le label — et ne compare rien d’autre : aucune recherche externe, aucune édition de tags. Tout ce qu’il produit est du texte : le tableau des noms proposés, un script PowerShell, un script shell, un CSV de relecture et une note de restauration.

  • Entrées : MP3, WAV, FLAC, AIFF/AIF, OGG, M4A et AAC ; le sélecteur accepte aussi tout audio reconnu par le navigateur. Un dossier est chargé via l’attribut webkitdirectory et via webkitGetAsEntry au dépôt, avec la liste plate de fichiers en secours.
  • Les noms seulement : aucun tag n’est écrit dans aucun fichier et les octets audio ne sont jamais modifiés.
  • Rien n’est envoyé : le plan de renommage et le générateur de scripts sont des fonctions pures sans E/S, et l’audio est analysé sur ta machine.

Limites à connaître

Mieux vaut les publier ici que de les découvrir en pleine remise à plat.

Le navigateur ne renomme rien sur le disque

Cette vue n’utilise aucune API d’écriture de fichiers : le plan vit en mémoire et dans le tableau, et seul du texte est téléchargé. Les fichiers sont renommés quand tu exécutes le script téléchargé sur ta machine, avec son journal de restauration ; l’outil ne déplace jamais un fichier de lui-même.

Un motif fixe, pas un moteur de gabarits

La proposition est toujours "Artiste - Titre" avec l’extension conservée : pas de placeholders {bpm} ou {key}, pas d’options de casse, pas de préfixes de numérotation, et ni le BPM ni la tonalité n’entrent dans le nom. La soupape, c’est de réécrire chaque nom à la main dans le tableau, champ par champ.

Des noms de fichiers seulement, un dossier à la fois

Le paquet stocke des noms de fichiers, pas des chemins : exécute-le sur un dossier concret et ne vise jamais un dossier parent. Comme la vérification de collision ne regarde que les noms, deux fichiers homonymes dans des dossiers différents sont aussi signalés.

La mémoire de ta machine est le plafond

Les formats compressés sont décodés par Web Audio pendant l’analyse, donc plus le titre est gros et long, plus cela prend de temps et de mémoire ; 20 000 pistes tourneraient autour de 5,98 Go face à une limite d’onglet mesurée de 4 192 Mo. La vue restaure au plus 500 analyses du cache local et le panneau bibliothèque jusqu’à 1 000.

Guides Academy recommandés

Métadonnées, organisation et sécurité de la bibliothèque avant de renommer en masse.

Parcourir tous les guides

Outils associés

Utilités complémentaires pour auditer et déplacer ta bibliothèque après le renommage.

Voir tous les outils